Arquiteturas Dense e MoE: como a NVIDIA explica a diferença entre modelos de IA e quando usar cada um
Um modelo com 30 bilhões de parâmetros consegue ativar apenas 3 bilhões a cada token processado e ainda assim aproveitar a capacidade total de um modelo maior. Esse é o exemplo utilizado pela NVIDIA em um artigo técnico recente para ilustrar o funcionamento da arquitetura Mixture-of-Experts (MoE), conhecida em português como Mistura de Especialistas. A publicação destaca o modelo Nemotron 3.5 Lightning como referência da abordagem.
A questão central levantada pelo texto é justamente como um modelo desse porte consegue manter a capacidade de um sistema maior utilizando apenas uma fração dos seus parâmetros por vez. A resposta está na forma como a arquitetura MoE organiza internamente seus componentes. Em vez de ativar toda a rede neural para cada token, o modelo seleciona apenas um subconjunto específico de parâmetros considerados relevantes para aquela tarefa.
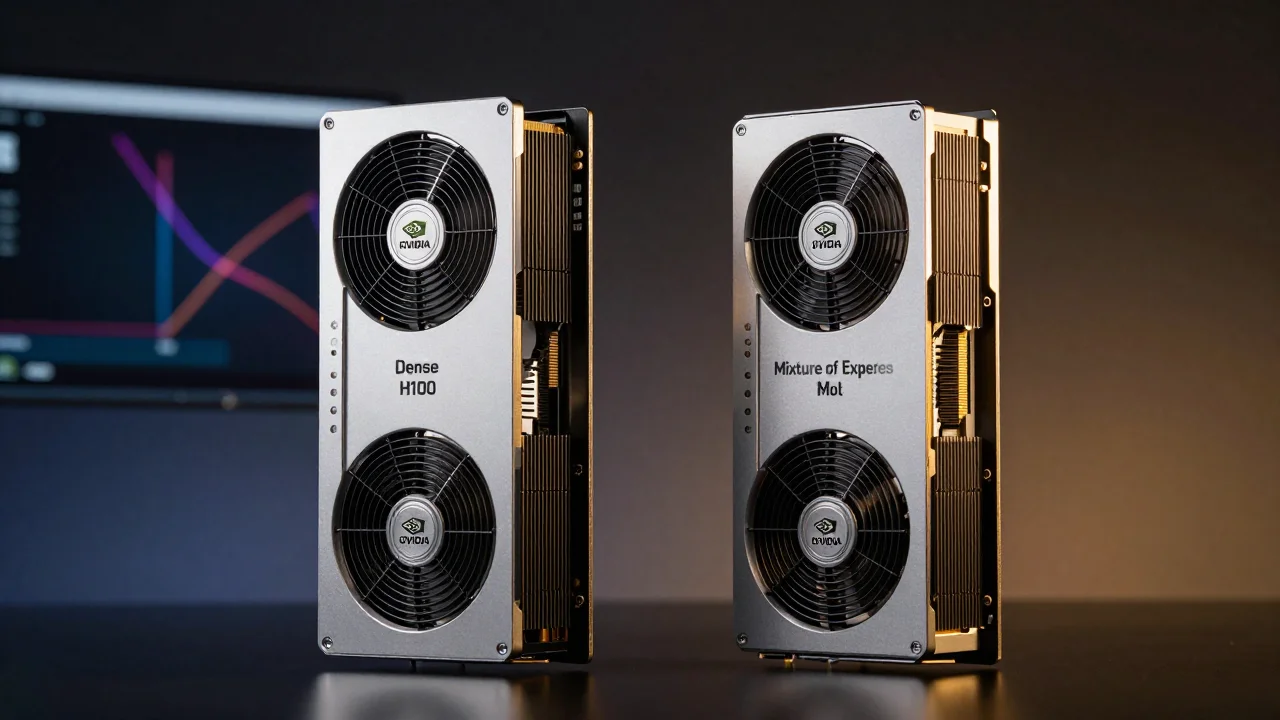
O artigo da NVIDIA contextualiza essa abordagem a partir de uma comparação entre os dois principais paradigmas de arquitetura de modelos de linguagem existentes atualmente: os modelos densos, chamados de Dense, e os próprios modelos MoE. A distinção entre eles não está apenas no tamanho total da rede, mas principalmente na maneira como os parâmetros são organizados e distribuídos durante o processamento das informações.
Nos modelos densos, todos os parâmetros disponíveis são ativados simultaneamente a cada token processado. Isso significa que o custo computacional é proporcional ao tamanho total da rede, independentemente da complexidade da tarefa. Por esse motivo, esses modelos tendem a exigir mais capacidade de processamento e memória, embora ofereçam um comportamento mais previsível em diferentes cenários.
Já os modelos baseados em MoE adotam uma estratégia diferente. Eles são compostos por múltiplos "especialistas", que são sub-redes menores e independentes dentro do modelo principal. Para cada token, um sistema de roteamento decide quais especialistas serão acionados. O resultado é que apenas uma parte dos parâmetros totais é executada a cada passo, o que reduz o custo de processamento por token sem necessariamente comprometer a capacidade geral do modelo.
A diferença entre o número total de parâmetros e o número de parâmetros ativos é justamente o que define o desempenho característico de um MoE. No caso do Nemotron 3.5 Lightning, mencionado pela NVIDIA, o modelo possui 30 bilhões de parâmetros totais, mas ativa aproximadamente 3 bilhões por token, uma proporção de um para dez. Essa característica permite que o sistema ofereça throughput elevado, ou seja, maior quantidade de tokens processados por unidade de tempo, em comparação com modelos densos de capacidade equivalente.
O conteúdo também reforça um ponto importante para desenvolvedores e equipes de infraestrutura: a forma como um modelo organiza seus parâmetros é tão relevante quanto o número total deles. A escolha entre Dense e MoE depende de fatores como o volume de requisições esperado, o tipo de workload e os recursos de hardware disponíveis. Modelos densos tendem a ser mais simples de treinar e implantar, enquanto modelos MoE oferecem maior eficiência em cenários de alto tráfego, nos quais múltiplos agentes ou usuários acessam o sistema simultaneamente.
Ao final, a publicação deixa claro que ambas as arquiteturas têm seu espaço no ecossistema de inteligência artificial. A decisão sobre qual abordagem adotar deve considerar o equilíbrio entre capacidade de processamento, memória disponível e latência desejada, em vez de buscar apenas o modelo com o maior número absoluto de parâmetros.